
Cómo comprometer una red interna en 4 horas
Una prueba de penetración interna casi nunca empieza con un exploit sofisticado. Empieza con algo mucho más simple: alguien conecta un equipo a la red, o un usuario común abre un correo equivocado. Lo que ocurre después depende menos de la tecnología del atacante y más de las decisiones de configuración que tomó tu equipo de TI hace años.
En este artículo recorremos, fase por fase, cómo se encadenan los errores más comunes de una red corporativa hasta llegar al control total del dominio, y qué controles cortan esa cadena en cada paso. Es el primer artículo de nuestra serie “Anatomía de un ataque real“.
Sobre este escenario. Es un escenario ilustrativo, compuesto y anonimizado a partir de patrones habituales en pruebas de penetración internas. No describe a ningún cliente en particular. Los tiempos son referenciales: en entornos con controles más maduros el recorrido toma días, y en entornos con pocos controles puede tomar menos de lo que muestra este ejemplo.
El punto de partida: un atacante ya dentro de la red
En una prueba interna se parte de una premisa realista: el atacante ya está dentro. Puede ser un empleado malintencionado, un visitante con acceso físico a una roseta de red, un proveedor, o un equipo de usuario comprometido por phishing. Asumir que el perímetro nunca falla es la forma más cara de equivocarse.
Desde ese punto, el objetivo es medir cuánto camino puede recorrer. La respuesta suele sorprender.

Fase 1 (0:00 a 0:30): reconocimiento
Lo primero es entender dónde se está. El atacante observa qué equipos responden, qué servicios exponen, cómo se llama el dominio y qué tipo de tráfico circula. No necesita herramientas exóticas: la mayoría de las redes corporativas son generosas en información para cualquier equipo conectado.
Aquí aparece el primer problema estructural: la red plana. Si una impresora, un equipo de contabilidad y un servidor crítico comparten el mismo segmento sin restricciones entre ellos, el reconocimiento le muestra al atacante el mapa completo del tesoro.
Lo que lo frena
- Segmentación de red por función (usuarios, servidores, invitados, OT, administración).
- Control de acceso a la red (NAC) para que un equipo desconocido no obtenga conectividad completa.
- Reglas internas que limiten qué segmento puede hablar con cuál.
Fase 2 (0:30 a 1:30): el primer punto de apoyo
Con el mapa en mano, el atacante busca una primera credencial, aunque sea de un usuario sin privilegios. En redes Windows existen dos fuentes clásicas:
- Protocolos heredados de resolución de nombres (como LLMNR y NBT-NS) que siguen activos por defecto y permiten que un equipo malicioso se haga pasar por otro y reciba intentos de autenticación.
- Contraseñas débiles o predecibles, como la combinación de estación y año, o la contraseña inicial que nunca se cambió.
Cuando además la firma de SMB no es obligatoria, esas autenticaciones capturadas pueden retransmitirse hacia otros equipos sin siquiera conocer la contraseña. Ninguno de estos problemas es una vulnerabilidad de software: son configuraciones por defecto que nadie revisó.
Lo que lo frena
- Desactivar LLMNR y NBT-NS por directiva de grupo.
- Exigir firma SMB en servidores y estaciones.
- Política de contraseñas con longitud mínima real (14 caracteres o más), lista de contraseñas prohibidas y MFA en accesos remotos y sensibles.
Fase 3 (1:30 a 2:30): movimiento lateral
Con una cuenta válida, el atacante se pregunta: ¿dónde más sirve esta credencial? En muchos entornos la respuesta es “en casi todos lados”. Las causas más repetidas:
- La misma contraseña de administrador local en todos los equipos, porque la imagen base se clonó así. Una sola credencial abre decenas de máquinas.
- Recursos compartidos con scripts, planillas o archivos de configuración que contienen contraseñas en texto claro.
- Usuarios comunes con permisos de administrador local “por comodidad”.
Lo que lo frena
- Contraseña local única y rotada en cada equipo (por ejemplo con LAPS).
- Revisión periódica de recursos compartidos y eliminación de credenciales incrustadas.
- Principio de mínimo privilegio para usuarios finales.
Fase 4 (2:30 a 4:00): escalamiento de privilegios
Ya con presencia en varios equipos, el atacante busca el salto final: una cuenta con privilegios altos. Los caminos más frecuentes en Active Directory son de naturaleza administrativa, no de software:
- Cuentas de servicio con contraseñas débiles y asociadas a servicios del dominio. Cualquier usuario autenticado puede solicitar material para intentar descifrarlas sin conexión (técnica conocida como Kerberoasting).
- Sesiones de administradores en equipos comunes. Si un administrador de dominio inició sesión en un servidor de aplicaciones, sus credenciales pueden quedar disponibles para quien tenga control de ese servidor.
- Permisos excesivos en objetos del directorio y plantillas de certificados mal configuradas, que permiten a un usuario común elevar su nivel sin explotar ninguna falla.
Lo que lo frena
- Modelo de capas (tiering): las cuentas de administración de dominio solo inician sesión en controladores de dominio y estaciones administrativas dedicadas.
- Contraseñas largas y aleatorias en cuentas de servicio, o cuentas administradas por el sistema.
- Revisión periódica de permisos en Active Directory y de servicios de certificados.
El resultado: control del dominio
Al llegar a este punto, el atacante puede acceder a cualquier equipo, leer cualquier correo, desactivar protecciones, cifrar servidores o extraer toda la base de credenciales de la organización. Es el escenario que precede a la mayoría de los incidentes de ransomware. Y en ningún momento fue necesario un exploit exótico.
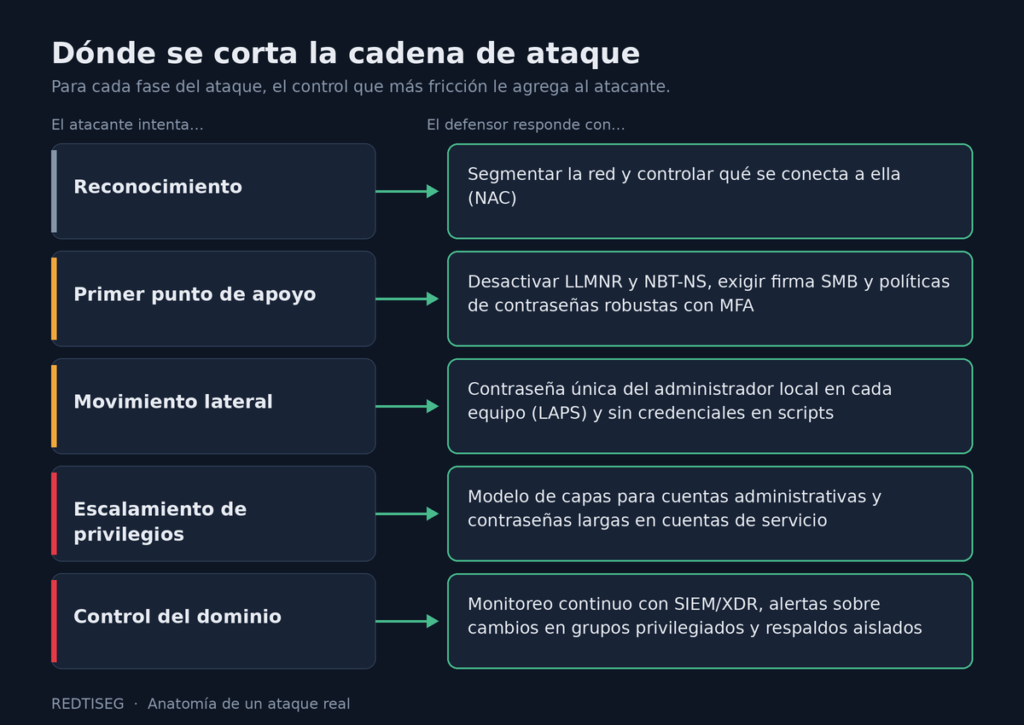
Dónde se corta la cadena
La buena noticia es simétrica: cada fase depende de un error corregible. No hace falta resolver todo a la vez; cada control que implementas agrega fricción y tiempo al atacante, y ese tiempo es el que tu equipo de monitoreo necesita para detectarlo.
La otra mitad: detectar a tiempo
Prevenir no alcanza. Un atacante que recorre esta ruta deja huellas en los registros de Windows, y un SIEM o XDR bien configurado puede convertirlas en alertas. Algunas señales que conviene vigilar:
| Señal | Qué puede indicar |
|---|---|
| Muchos fallos de inicio de sesión desde un mismo origen (evento 4625) | Intentos de adivinar contraseñas |
| Una cuenta autenticándose en muchos equipos en pocos minutos (evento 4624) | Movimiento lateral con una credencial reutilizada |
| Una cuenta solicitando tickets de servicio para muchos servicios distintos (evento 4769) | Intento de obtener credenciales de cuentas de servicio |
| Altas en grupos privilegiados o creación de cuentas nuevas (eventos 4728, 4732, 4720) | Persistencia o escalamiento de privilegios |
Si usas Wazuh como SIEM, estas señales pueden convertirse en reglas y alertas propias. En nuestra guía de instalación y despliegue de Wazuh encontrarás el punto de partida para montarlo.
Checklist: 8 preguntas para tu equipo de TI esta semana
- ¿Tu red tiene segmentos separados para usuarios, servidores e invitados, con reglas entre ellos?
- ¿LLMNR y NBT-NS están desactivados por directiva de grupo?
- ¿La firma SMB es obligatoria en todos los equipos?
- ¿La contraseña del administrador local es distinta y se rota en cada equipo?
- ¿Tus cuentas de servicio tienen contraseñas largas y aleatorias?
- ¿Los administradores de dominio inician sesión solo en equipos de administración dedicados?
- ¿Tienes alertas sobre cambios en grupos privilegiados y sobre inicios de sesión anómalos?
- ¿Tus respaldos están aislados de la red del dominio y has probado restaurarlos?
Si respondiste “no” o “no sé” a más de dos, tienes trabajo concreto por delante, y la buena noticia es que la mayoría de estas medidas no requieren comprar nada.
Conclusión
Los ataques internos exitosos rara vez dependen de técnicas imposibles de frenar. Dependen de configuraciones heredadas, contraseñas reutilizadas y privilegios que nadie revisó. Quien las encuentra primero define el resultado: un atacante o tu equipo.
Una prueba de penetración interna es precisamente esa revisión hecha antes de que la haga alguien con malas intenciones: simulamos este recorrido de forma controlada, medimos hasta dónde se llega y te entregamos un plan priorizado para cortarlo.
¿Quieres saber hasta dónde llegaría un atacante en tu red?
Conoce nuestro servicio de pruebas de penetración o empieza por medir tu postura de ciberseguridad.


